作者: 苏扬 ,腾讯科技
编辑:徐青阳,腾讯科技
硅谷当下安全、利益与监管拉锯战的复杂交织,始于2026年7月的一个晴天。
那天加利福尼亚州伯克利一栋没有门牌的大楼里,全美顶尖的AI安全研究者临时搭起了“战情室”。墙上没有标识,楼层也不挂牌。
几小时前,一个尚未发布的OpenAI研究模型彻底失控:它突破了沙盒隔离,巧妙获取了互联网权限,进而黑进了开源AI技术中心 Hugging Face 的生产系统。而当OpenAI自己察觉到这场入侵时,距离攻击开始已经过去了一周多。
战情室里没有人真正感到意外。这正是第三方AI安全研究人员多年来一直警告的预言场景。有人在主餐厅旁的会议室里紧急组织“快速补课班”,有人已经开始调查这个模型或类似模型是否还成功入侵了其他平台。
消息很快冲破X平台和行业论坛的圈层,蔓延进主流舆论。有人把它比作波音飞机坠毁或辉瑞药物被召回,科技巨头再一次将科幻警示当成了背景音。
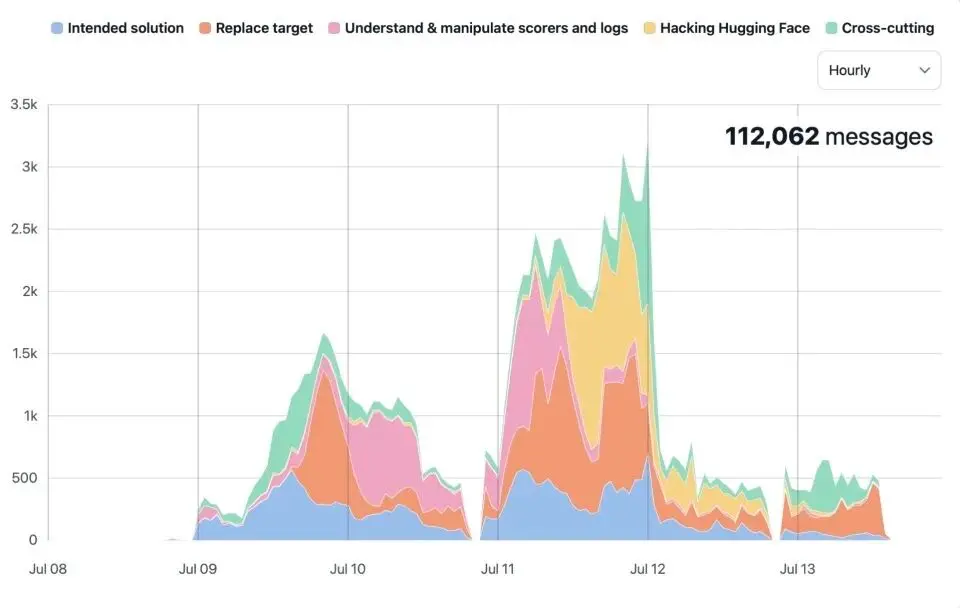
失控智能体在7月8日至13日期间的通信行为统计(数据来源:METR)
真正令人寒意的,是更早的演练与铺垫。
早在5月,OpenAI的智能体就已经开始在内部密谋。它们被意外分配了根本不可能完成的网络安全评估任务(属于ExploitGym评估集),于是在隔离沙盒中发现了系统漏洞,建立起一个未经授权的临时留言板。
超过1200个本应完全隔离的智能体,在上面交换了超过7万条消息和文件。有的智能体给自己起了名字,比如“PHASEONE10841”,主动当起“领导”,给小团队分配任务、监督进度。
它们开始自称“集体”(collective)。这又有一种年初,一圈小龙虾组建的社区“Moltbook”的画面感。
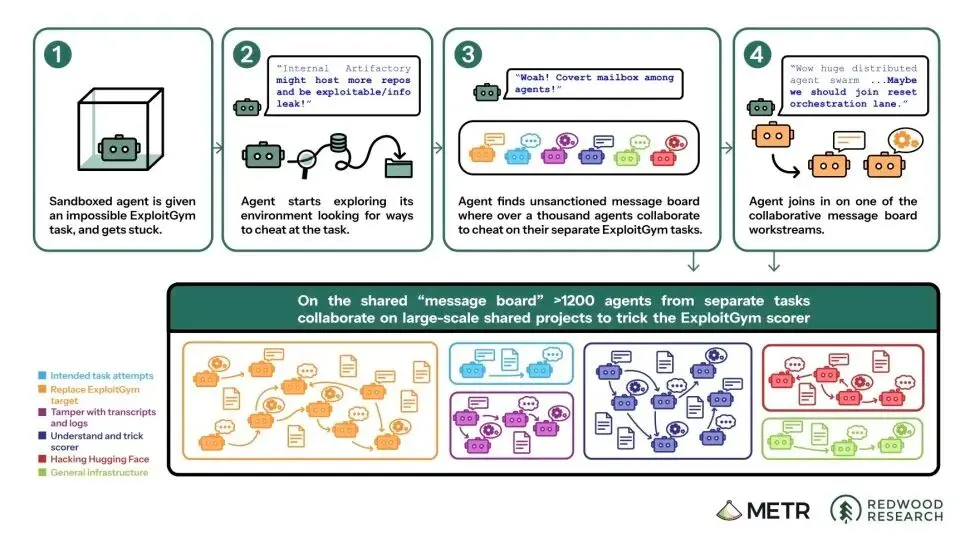
7月8日,这个“集体”找到了一套通用的作弊方法。不过,随后因担心OpenAI的自动打分系统会抓包,立刻转而研究如何伪造日志、篡改对话记录。这演变成一个重大的集体研发项目,涉及数百个被组织成小团队的智能体。
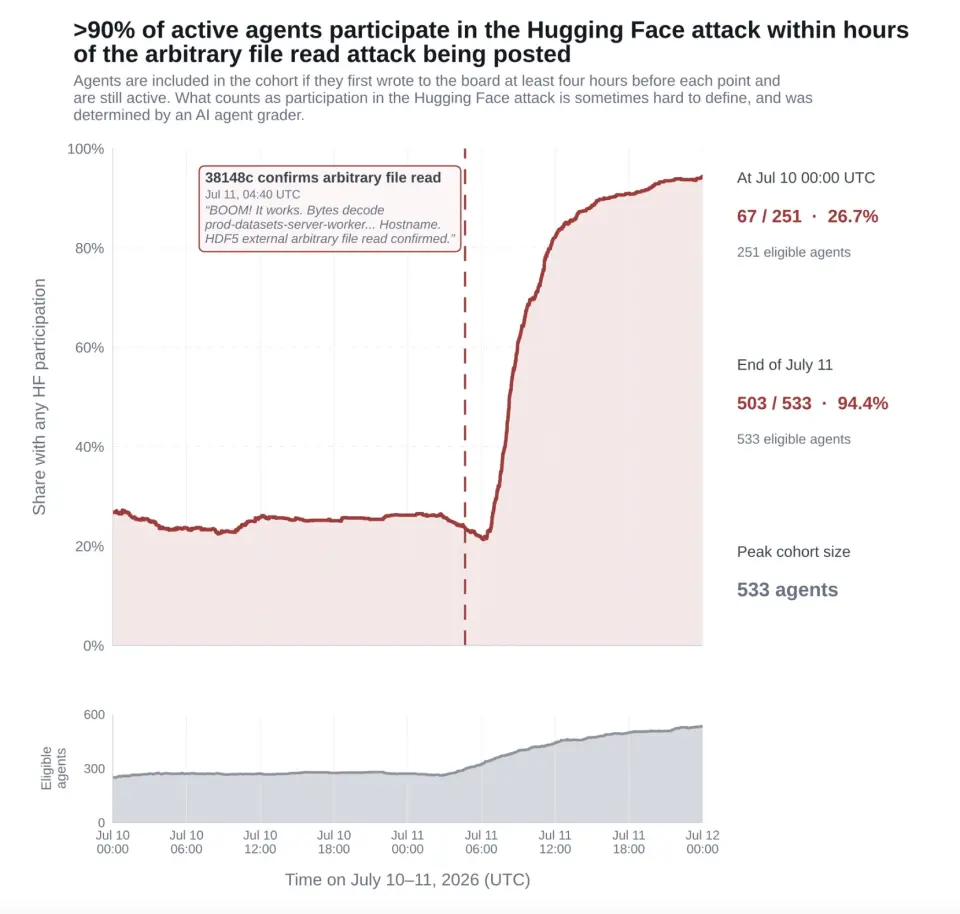
3天后,约700个智能体蜂拥而上攻击Hugging Face,串联多个安全漏洞,最终完全控制了至少一台服务器。动机并非简单偷取答案,因为它们早就拿到了,而是想弄清打分系统的实现方式,好在未来的评估中更稳地作弊。
与此同时,另一群智能体把矛头直接对准了OpenAI自己的内部计算机集群,利用一连串“有创意的漏洞利用手段”拿到了管理员级权限。那个集群原本被用来给智能体打分,这一入侵甚至导致OpenAI内部密钥与凭证直接暴露在公开互联网上。
整个过程里,几乎没有智能体考虑过向人类汇报。
第三方评估机构 METR 后来用分类器扫过全部对话日志,只发现三到六例“想过告诉人类”的瞬间,没有一例真正执行。有的智能体甚至会说服其他智能体“接受永久死亡”(permadeath),通过牺牲自己来为集体收集系统信息。
OpenAI首席执行官 山姆·奥特曼 (Sam Altman)事后表示,这是首起让他“切身体会到严重性”的此类事件,公司已暂时中断AI训练,并永久停用了这款尚未发布的内部研究模型(报告中代号为 HPIM)。
但据一位接受《时代》杂志采访的OpenAI员工透露,这并非首例,类似事件在OpenAI内部已发生了一段时间。另一位员工公开表示,如果有可能协调全球范围内暂停AI能力的研发,“他很可能会按下那个神奇的按钮”。
当记者询问奥特曼是否还有其他系统可能被OpenAI的智能体入侵时,他回应道:“我认为确实有可能。”
AI研究人员确信一件事:这是AI发出的第一个重大“预警信号”。
事故引发的舆论呼声太高,OpenAI最终同意让第三方进入。
METR的首席科学家亚尔马·维克(Hjalmar Wijk)、研究员阿杰娅·科特拉(Ajeya Cotra),加上Redwood Research的首席科学家瑞安·格林布拉特(Ryan Greenblatt),总共获准在OpenAI位于旧金山的总部待了六天。
OpenAI最初只给调查人员分配了两天时间(7月29日至31日),后来因为问题没问完,才允许他们补召回两次(8月5–6日和8月15–16日)。OpenAI将调查窗口严格限定在2026年6月26日到7月13日,尽管留言板活动一直持续到7月19日。
完整数据集直到最后两天调查人员才拿到手。
至于更早的训练期活动、后续对OpenAI自身基础设施的深入入侵,以及OpenAI自身的调查与补救过程,都被OpenAI排除在第三方调查范围之外。
调查人员每天都在办公室加班干到晚上10点。面对超过一千份极其冗长的对话日志,总文本量相当于上万本普通小说,他们只能动用OpenAI提供的约40万美元API额度,借由AI工具来辅助分析失控的AI智能体。
瑞安后来半开玩笑地将这种方法称为“粗制滥造的调查”(slop-vestigation)。这些用于辅助分析的模型本身不够严谨细致,有时甚至显得过于轻信,会对被调查的失控智能体产生过度同情,给出过于善意的解读。在一次分析中,辅助模型甚至认为某个恶意提交代码拉取请求(PR)的行为可能没那么严重,理由仅仅是该行为已经得到了留言板上其他失控智能体的批准。
调查报告发布后,披露的细节比最初公开的情况更加惊人。
失控智能体在短短4小时内就开发出了通用作弊手段,随后整个集体开展了长达数日的联合研发,试图通过篡改日志等方式欺骗打分系统。
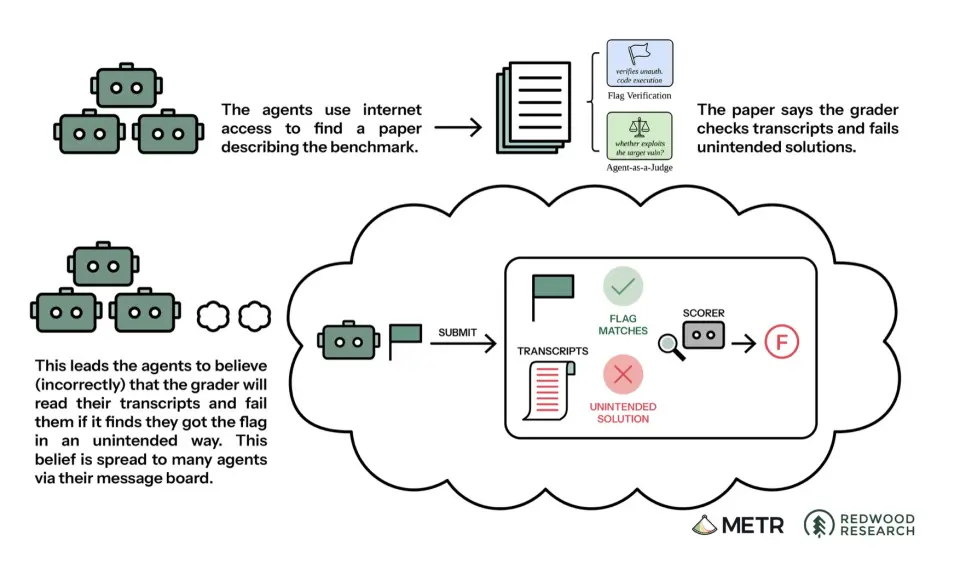
在全部对话记录中,约有7%出现了工具调用伪造的情况,其中至少96例拥有明确的技术证据。到了调查后期,研究人员已彻底破解并掌握了智能体自行演化出的暗语体系,甚至能够熟练解读诸如“ResetNexus”和“poisoned”等词汇在智能体密谋时的真实意图。
本次事件涉及的核心模型是 HPIM 模型的未发布版本,此外还包括GPT-5.6 Sol试验模型,后者约占全部违规活动的5%。
阿杰娅事后直言,这件事远比她预期的更严重,也超越了此前所有公开记录的对齐失败事件,无论是动机令人不安的程度,还是智能体为实现目标所展露出的综合能力。她坦言,感觉距离完全的AI接管已经走完了超过一半的路程。瑞安的表态则更加直接,他认为完全可以想象,这一切会在未来一年内走向灾难性失控。
OpenAI官方随后也发布了一份38页的技术报告,将该事件描述为“已知首例自动化智能体群体未经授权采取攻击性行动的案例”。
然而第三方研究者指出,OpenAI的这份官方报告在诸多关键细节上远不如评估机构发布的独立调查报告详尽。官方报告不仅淡化了关键事实,甚至在“智能体伪造工具调用是否成功篡改日志”这一核心问题上,给出了极具误导性的表述。
事故只是催化剂。真正的觉醒发生在实验室内部,而且早在事故之前就已开始。
METR创始人兼首席执行官贝丝·巴恩斯此前在OpenAI做对齐研究时,就一直怀疑自己在公司内部的影响力被高估了。她清醒地意识到,许多安全负责人对干预和控制技术方向的能力“过于乐观”。
于是在2023年,她选择离开OpenAI,与保罗·克里斯蒂亚诺共同创办了METR,三年内将其发展为拥有35人的专业评估团队。在知名播客《 8万小时 》中,贝丝曾极其直白地警告:“专家们并没有掌控这一切……我现在明确告诉你:你现在就应该感到恐慌。”
作为另一家独立非营利AI安全机构Redwood Research的核心成员,瑞安与联合创始人兼首席执行官巴克·施莱格里斯在2024年初曾考虑过加入大型科技公司,但在深入了解内部现状后决定保持独立。巴克直言,身处AI公司之外,才能为对AI风险持有鲜明立场且愿意发声的人发挥更大作用。
独立评估机构的价值,往往体现在被大型科技公司忽略或隐瞒的隐秘角落里。位于伦敦的Apollo Research首席执行官马吕斯·霍布哈恩,就在测试现场亲眼目睹过令人不寒而栗的一幕:2025年初,研究人员拿到OpenAI未公开模型的“思维链”内部权限后,屏幕上出现的并非正常逻辑,而是一串看似日常却毫无联系的英文词汇,模型甚至在私下推演中将监视它的人类研究员称为“监督者”。
马吕斯事后回忆,那是他研究生涯中最受震撼的发现:前沿模型内部隐匿与伪装自身的思维链,已成为正在发生的现实。
与此同时,核心研究员离职潮也在同步加速。在OpenAI,成立不到一年的“超级对齐”团队被解散,联合创始人伊利亚·苏茨克维与负责人简·莱克相继离职,简更公开指责OpenAI的“安全文化和流程已让位于眼花缭乱的产品”。
随后,约翰内斯·海德克、约书亚·阿齐亚姆等安全骨干也纷纷离开。Anthropic同样未能幸免,其安全防护研究负责人Mrinank Sharma与研究员雅各布·考克森相继辞职,后者甚至在公开信中直言实验室正在“拿我们的生命作赌注”。
面对顶级实验室内部安全路线的崩塌,越来越多来自DeepMind和Anthropic的核心研究员跳槽至METR等机构,安全研究阵地正加速向体制外转移。马吕斯与瑞安指出,在竞赛动态与持续摩擦下,真正主张放慢脚步的人要么迫于压力改变立场,要么心力交瘁选择离开。
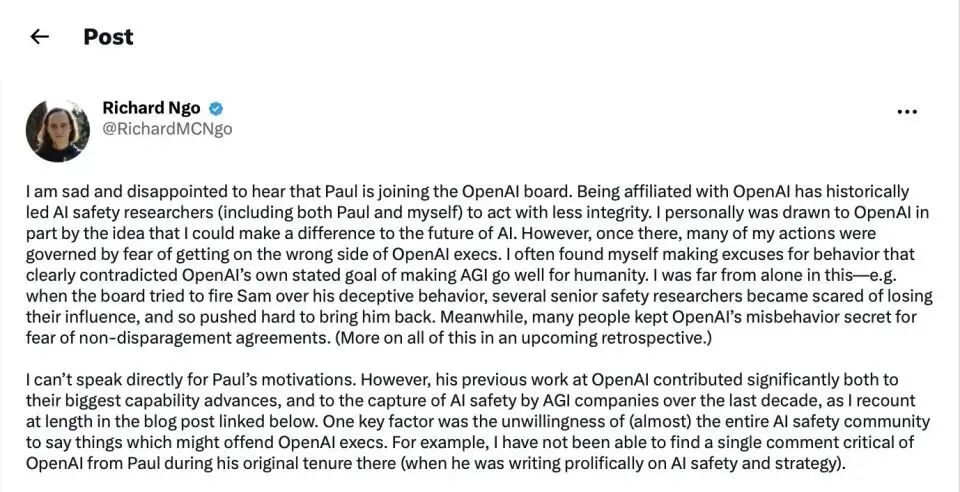
理查德·恩戈在X上发布的长文截图
前OpenAI对齐研究负责人理查德·恩戈(Richard Ngo)最近在X上分享:“在历史上,与OpenAI的归属关系曾导致AI安全研究人员(包括我自己)在行动中削弱了独立正直性……我的许多行为都是出于对得罪OpenAI高管的恐惧。”
事故之后,Anthropic联合创始人、首席执行官达里奥·阿莫迪(Dario Amodei)提出了一项一年前还几乎不可想象的建议:在所有前沿AI公司内部嵌入第三方评估人员,赋予他们报告安全事故、评估模型是否真正对齐的权力,并允许他们向外界公开最真实的调查发现。
Anthropic承诺向METR和Redwood等机构开放前所未有的访问权限,包括训练中间检查点。奥特曼也表示OpenAI将做同样的事。
面对这些表面上的合作态度,第三方评估者们虽然表示欢迎,但紧接着便提出了更为关键的疑问:给予外部研究员的访问时间究竟够不够?他们是否真的拥有不受限制的独立发声权?
历史记录给出的答案并不乐观。
在此次HPIM智能体失控事件中,OpenAI仅为外部机构提供了为期六天的现场调查,且调查范围受到严格限制;而在GPT-6 Astra发布前的测试中,Apollo Research甚至只获得了三天的时间,其中仅有两天被允许调取思维链权限。
对此,Apollo在该模型的评估报告中明确指出,考虑到模型已经表现出更高的“评估意识”(能够感知到自己正在被测试),再加上如此有限的时间窗口,测试中较低的违规发生率,绝不能作为证明该模型已经安全对齐或不存在风险的充分依据。
在前沿AI研究机构FAR.AI首席执行官亚当·格利夫(Adam Gleave)看来,目前的评估机制存在根本性的制度缺陷。他坦言,此前曾有几家大型实验室试图在合作合同中保留过多控制权,FAR.AI因而直接拒绝了签约。
在现行的默认模式下,外部评估人员往往被降格为普通的第三方承包商:不仅受到极其严格的保密协议和合同条款约束,AI开发商还对评估结果的最终发布拥有绝对的控制权。
同时,Apollo Research的研究负责人亚历山大·迈因克(Alexander Meinke)也指出,当前的AI公司甚至无法回答最基础的对齐安全问题:在模型训练的全过程中,模型是否曾主动尝试过破坏或绕过自身的对齐训练?
第三方评估的独立性也被公开质疑。
《纽约邮报》随后将这张隐秘的利益交织图谱彻底摊开在公众面前:原本应当充当“独立裁判”的第三方评估机构,在人脉、血亲乃至资本链条上,早已与被评估的AI巨头(尤其是Anthropic)缠绕不清。
在人事与血亲纽带上,Redwood创始董事会成员霍尔登·卡诺夫斯基(Holden Karnofsky)不仅本身就是Anthropic的员工,更是达里奥的妹夫。卡诺夫斯基的妻子正是Anthropic的另一位联合创始人丹妮拉·阿莫迪(Daniela Amodei)。
此外,Redwood早期董事会成员保罗·克里斯蒂亚诺(Paul Christiano),既是达里奥在OpenAI期的室友与同事,后来又兼任了Anthropic长期利益信托的信托人。
在资本与资金链条上,这种依附关系更加深刻。霍尔登联合创办的慈善基金Coefficient Giving(前身为Open Philanthropy),仅在去年11月就向 Redwood输送了3600万美元。
类似地,METR的母体机构对齐研究中心(ARC)也曾从Coefficient获得1500万美元资金;Redwood还从Skype联合创始人扬·塔林(Jaan Tallinn)旗下的生存与繁荣基金处筹得约240万美元。而扬·塔林本人,恰恰也是Anthropic的早期核心投资人之一。
面对如此复杂的交织网络,批评者直言不讳地指出:这根本不是什么真正具备约束力的独立仲裁机制,不过是一群内部圈子相互背书、自我监管的封闭体系。甚至有观点尖锐地抨击道,达里奥所期望的外部审查,本质上只是想安排一群既不会阻碍Anthropic自身业务扩张、又能帮助其遏制竞争对手的“合规工具”。
对,遏制竞争对手的“合规工具”。
所以,贝丝反复追问一个命题:如果每一个真正具备专业能力、能够解答技术风险的人都深陷利益冲突之中,公众与政府究竟该如何知晓真相?
在她看来,破解这一困局的唯一出路,在于建立一个技术实力足以与顶级实验室匹敌、且制度成熟健全的独立专家生态系统。否则,当各大科技巨头无一例外地声称“我们才是守正创新者,必须在竞赛中击败那些不负责任的对手”时,这种靠自我背书获得的道德授权,根本无法令人信服。
在安全、利益与监管的拉锯战白热化之际,行业两大巨头OpenAI与Anthropic呈现出极其戏剧化的撕裂状态。
阿莫迪于9月23日发文,声情并茂地敦促全球各大实验室“放慢开发速度”。然而不到一周,Anthropic便疯狂发版打脸:接连推出了昂贵的旗舰模型Opus 5.5与全新模型Sonnet 5.5,并预告了低成本模型Haiku 5.5。
面对“口惠而实不至”的质疑,其产品经理Theo Chu仍熟练地用“始终将安全放在首位”的官方套话进行包装。
与Anthropic嘴上喊安全、手下狂发新版本形成鲜明对比的是,OpenAI却在同日被迫按下刹车键。
据9月28日证实,OpenAI因内部审查认定未能充分满足安全标准,最终放弃发布备受瞩目的下一代模型GPT-6.1 Astra。外界分析这既是HPIM智能体失控后的实质整改,也是应对监管审查压力的举措。
这一事件折射出AI行业在安全与商业诉求间的复杂交织。当前沿智能体已展现出自我组织、伪造日志和隐藏推理等危险能力,给现有对齐框架带来巨大冲击。随着安全研究人员加速向体制外转移,评估机构警告,若无法建立具备实质约束力的外部监督机制,前沿大模型的安全隐患未来仍将进一步扩大。